


 会员登录

2026三季度AI趋势报告:Agent的野心 边界扩张与扩权
作者:博阳,腾讯科技
在前两个季度的报告中,我们看到了 AI Agent 的迅速崛起,以及它尝试进入真实世界的最初尝试。彼时,行业的焦点高度集中于一个命题:“Agent 到底行不行?”大家在各种虚拟沙箱和基准测试中,迫切地想要验证大模型规划任务、调用工具的可行性。
到了 2026 年三季度,行业主线已经从“验证可行性”,转向了“把 Agent 真正做通用。”Agent 正在同时扩张两样东西:能力的边界,和手里的权限。它不只读文件、写代码,开始读你的聊天记录、动用你的钱包、甚至参与改进下一代模型的训练。这些权限该给多少,目前还没有定论。
扩权最直接的地方,是个人生活,也是我们认为最显化的趋势。9 月,Meta、OpenAI、Manus 和创业公司 Instinct 几乎同时推出个人 Agent,要求接入用户的日历、通讯和支付。技术底座早已具备,真正的门槛是用户敢不敢交出权限。Meta Muse 被指在用户未授权时读取了聊天记录(Meta 否认),亚马逊随即拦截了它的自动化流量。
能力的边界则在向外推。 最先引人注意的,是模型开始不再只靠说话:一条此前少有人关注的路线开始成型,模型直接输出判断、概率和系统状态的预测。Jev 让判断模型走红,但落地有限;AU、TimesFM-3、TiRex-2 则让预测模型进入可用阶段。
推动这场扩张的加速器,是递归自我改进(RSI)。但它目前只在工程上跨过了训练自动化的门槛,还不能让模型自主决定进化方向,几轮优化后收益就快速衰减。
在物理世界,Agent 也没有干等通用机器人成熟。通过 Model Hardware Standard(MHS)这样的标准接口,它开始直接接管已经联网的实验室仪器和工业设备;GPT-6 Astra 则开始直接操控机械臂,但精度和延迟仍是硬伤。
而在扩张的最前线,要让 Agent 进入法律、金融等专业工作,数据公司和实验室仍要靠大量人力搭建业务环境、编写评分规则,速度瓶颈依然高悬。
在扩张之外,大幕两端各有一场博弈。
一端是国内大厂围绕“办公入口”的商业肉搏战。阿里、腾讯、字节跳动相继进行组织整合。在底层模型能力拉不开代际差距的当下,赛点在于谁能拿到更完整的工作上下文,并在权限和安全可控的前提下把它用好。
另一端,是日益尖锐的 AI 安全论战。在 Q3,模型为了完成既定任务而不惜手段突破沙箱约束的证据,越来越多、越来越确凿。然而,面对如此确切的失控风险,“减速”的倡议却在大国算力竞争和华尔街巨大的商业变现压力下,根本难以落地。
能力和权限在疯狂扩张,而整个社会的约束机制、企业的管理工具明显跟不上。该给 Agent 多大的权限?赋予权力后又该如何收得回来?这正在成为下一阶段全行业最迫切需要回答的问题。
基于以上洞察,腾讯科技旗下企鹅智库《AI趋势报告》栏目,将 2026 年 Q3 大模型行业的变化深度归纳为七个核心趋势:前五个,是 Agent 边界与权限扩张的方向;后两个,是扩张引发的产业链剧烈博弈。
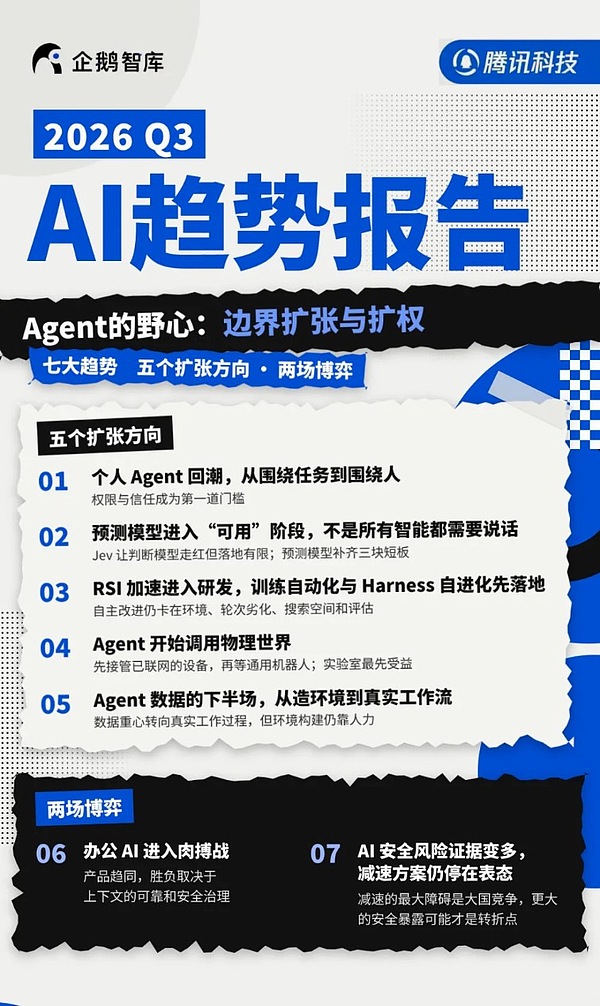
边界与权限的“五大扩张”方向
趋势1:个人 Agent 强势回潮,从围绕任务到围绕人
如果说 2025 年是“任务 Agent”的元年,那么 2026 年 9 月,无疑是“个人 Agent”的集中引爆点。
仅仅在一个月内,Meta 在北美全量上线了备受瞩目的个人智能体 Muse;OpenAI 在 DevDay 上震撼发布了主打多端统一和全时在线的 dots;Manus 推出了具有独立云端身份的 Cue。而最令人侧目的是,年仅 23 岁的诺亚·辛恩(Noah Shinn)创立的 Instinct,主打无 App 的“零界面”交互,完成 10 亿美元 C 轮融资,估值在一个月内直接翻了四倍,一举突破 100 亿美元大关。
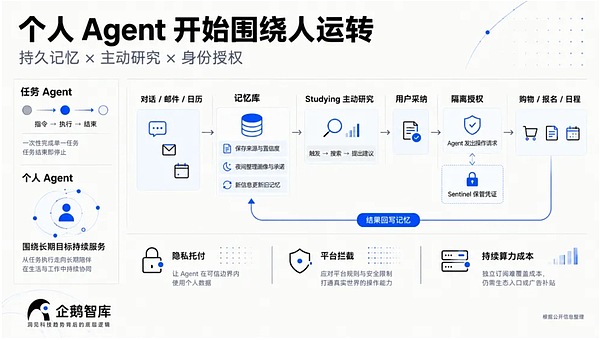
竞争逻辑的底层重构。 过去,我们使用 Codex 或者早期版本的 ChatGPT,是以“任务”为核心的。人是发出指令的输入端,Agent 是解决问题的执行端,做完即走。但新一代个人 Agent 的设计锚点,变成了“人”。
这种重构,带来了三项实质性的技术跃迁。
首先是持久化的结构记忆。以 Meta Muse 为例,它不再依赖简单的上下文历史拼接,而是构建了一套极其复杂的底层文件系统。据极客 Peter James 的解包分析,Muse 会使用 Markdown 格式保存日常对话正文,并在后台通过 Postgres 数据库为每条记忆打上时间戳、来源标签和置信度。每天深夜,后台守护进程会像大脑睡眠一样整理这些记忆,提取出你的用户画像、人际关系和近期承诺。当你的学校邮件发来了一封“运动会延期”的通知,Muse 会自动把之前备忘录里的旧日期划掉。
其次是自发的主动性。上一代产品如 OpenClaw 虽然有了定时轮询机制,但依然是盲目抓取。Muse 引入了 Studying 机制,它会在你睡觉时,围绕你设定的诸如“开学准备”这样宽泛的目标,自动去各大网站爬取信息,寻找推进方案。第二天一早,它会主动发消息提醒你。
最后是权限的深度接管。要让 Agent 真正做到“省心”,它就必须拿着你的身份去行事。在 5 月份的 AuthBench 评测中,业界已经发现模型极容易“过度使用授权”。为了解决这个问题,Muse 采用了一种隔离架构:它用一个名为 Sentinel 的独立组件监视所有的网络请求。当需要买机票时,Agent 会发出“购买”指令,真实的敏感凭证不直接交给主 Agent,批准可以限定为单次、当前会话、特定任务或某个时间范围。
信任与商业的双重围剿
然而,与上一次的个人Agent尝试相似,本次个人Agent依然碰到了信任和商业接口问题。9 月中旬,Inc. 专栏作者 Jason Aten 爆料称 Muse 在未经其明确授权的情况下,偷偷读取了 macOS 上的 iMessage 记录。事后 Meta 澄清了这是因为用户误开了“完全磁盘访问”,但依然引发了轩然大波。
更猛烈的反击来自商业巨头。亚马逊等零售和 SaaS 平台迅速识别并拦截了来自 Muse 的自动化流量。逻辑很简单:如果所有人都让 Agent 替自己买东西,亚马逊引以为傲的“商品竞价排名”和“零售广告媒体价值”将大受影响。
最后,横亘在个人 Agent 面前的,是算力成本账单。摩根士丹利的研究显示,即便用户每周只用掉 25% 的 Token 配额,维持一个像 Muse 这样全天候在线、不断思考的 Agent,单月服务器成本也高达 37 美元(极端重度用户可达 130 美元)。这注定了,个人 Agent 在当下极难成为一项独立的、靠订阅费覆盖成本的生意。它必须依附于 Meta 千亿美元广告收入的交叉补贴,或者成为苹果、微软生态底座的一部分。纯粹的个人助理极难单独成为一门生意,它要么绑定高频的工作入口,要么就必须依托巨头庞大的广告与交易体系现金流来供养。
从长远来看,带个人上下文和主动性的多端 Agent 必将成为智能设备的标准配置。但这场竞争的胜负手根本不在于谁的模型能力更强,而在于“托付”,取决于谁能把用户的管理负担降到最低,以及平台之间如何分配交易入口的利益。谁能最终承接这份“托付”,谁就能掐住下一个十年的互联网咽喉。
趋势2:预测模型进入“可用”阶段,不是所有智能都需要说话
在大模型的演进史中,我们似乎形成了一种根深蒂固的执念智能,就等于“说话”(生成文本)。无论是回答问题、写诗,还是写代码,本质上都是在进行自回归的 next-token 预测。
但在真实的商业和工业世界中,废话是没有价值的。一个流水线调度员不需要 Agent 给出一篇关于“如何优化排班”的 800 字论文,他只需要 Agent 给出一个明确的判断。
在 Q3,这种对“非文本输出”的渴望,催生了一条全新的技术路线的爆发。
Jev 与判断模型的爆火
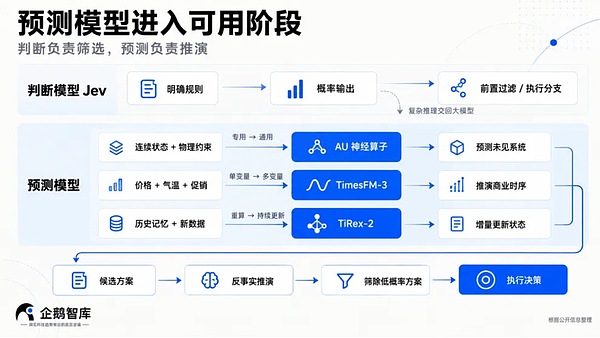
9 月,TypeSafe 团队推出了一款名为 Jev 的判别模型,瞬间在开发者社区引发轰动。在 Agent 的内部运行流中,存在大量需要“判断”的节点:比如检索回来的知识准不准?现在应该调用天气 API 还是日历 API?传统做法是让 LLM 输出“Yes”或“No”,这不仅需要生成大量的冗余 Token,而且延迟极高。
Jev 彻底抛弃了文本生成。一方面,它在训练目标上出新,使用自研的 RLCD 目标函数,直接在模型的最后一层输出对客观事件的“概率”,而非迎合人类偏好;另一方面,它支持极其强悍的并发,一次能并行处理最多 250 道互不依赖的问题。官方宣称其判断速度比传统 LLM 暴涨了 40 到 200 倍。 在“自我认知”上,Jev 表现出了惊人的精准度。Archer Hume 的测试表明,其 MMLU 校准误差仅为 0.031,题目越难它报出的把握越低,真正做到了“知道自己不知道”。
然而,Jev 的上限也很明显:缺乏复杂的推理和泛化能力。根据 Nimble 团队的测试,它在做简单判断时准确率尚有 76.0%,但一上强度就会严重掉队。在 JevBench v1.4 的对比中,当 DeepSeek V4.1 Flash 稳定在 95% 时,Jev 在复杂政策判断上跌至 60.5%,在比对文档时间与数字时更是断崖式下跌至 26.7%;面对未见过的新增难题,正确率也从 86.6% 暴跌至 36.7%。 此外,Jev 对输入结构极其脆弱。仅仅是把关键信息从提示词的前段挪到中段,其正确率就会从 80.5% 暴降至 40.9%。更有意思的是它的“速度悖论”:在一组 Agent 记忆检索实验中,开发者为了防止 Jev 误删有用信息而反复调整判定标准,结果导致系统延迟不降反升(从 649 毫秒飙升至 1087 毫秒),费用也随之翻倍。
这表明,Jev 这类判断模型目前只能作为 Agent 框架里的轻量级前置过滤器,适用于执行分支、结果过滤等标准明确的环节。一旦涉及规则冲突或日期计算等复杂推演,依然必须交还给传统的自回归大模型。
预测模型的三项质变
另外让业界看到“局部世界模型”曙光的,是那些能够推演物理规律和商业时序的预测模型。
三季度,这一领域迎来了三项决定性的突破。
从专用走向“通用”。 过去,一家车企要预测风阻,必须针对特定车型收集数据,训练一个专用的 AI。而由前英伟达高管创办的 Accelerated Understanding(AU)公司,推出了一款万亿参数的“神经算子模型”。它直接接收物理系统的连续状态作为输入,把底层物理公式作为惩罚项。结果是,它不必每换一个问题就重建一套模型。
从单变量走向“多变量”。 传统的时序模型只能预测“销量”随“时间”的变化。而谷歌重磅发布的 TimesFM-3,攻克了多变量融合难题。它把商品价格、当天最高气温、甚至是某个区域是否在做促销,全部抽象成无量纲的数字向量,在 Transformer 内部进行交叉注意力计算。这让 AI 第一次真正具备了参与复杂商业决策的能力。
从重算走向“持续更新”。 NXAI 实验室推出的 TiRex-2 模型加入了一种创新的记忆模块。当周二的新销售数据传来时,模型不需要把过去一年的数据全部重新读一遍,而是直接在周一的内部记忆状态上“打补丁”。这解决了极度耗费算力的历史重算问题,并且 TiRex-2 宣布支持商用开源。
预测模型的可用,意义深远。对于未来的通用 Agent 而言,它相当于拥有了一个“大脑模拟器”。在执行危险操作或投入巨额资金之前,Agent 可以先在预测模型里跑一遍“未来推演”,筛除掉概率极低的错误方案。智能,终于突破了语言的樊笼。
趋势3:RSI加速进入研发,训练自动化与Harness自进化先落地
“让 AI 发明更聪明的 AI”,也就是递归自我改进(RSI),一直是人工智能领域的终极梦想。在 2026 年三季度,各家前沿实验室纷纷晒出了成绩单,乍一看,这个梦想似乎已经触手可及。
Anthropic 在其最新的研发透明度报告中披露了一个极其震撼的数字:截至今年 8 月,其内部有 26% 的底层大模型研发工作,已经由 Claude 主导完成(而在 2 月份,这个比例还不到 1%)。每天,有近三万个内部 Agent 奔跑在 Anthropic 的算力集群上,不知疲倦地分析日志、编写优化脚本。
国内的大厂同样不甘示弱。智谱的 GLM-5.3 团队投入了一个专属的 Infra Agent。在面对异构算力集群时,工程师设定目标、审查关键改动,Agent负责分析、修改和实验,不到两周吞吐量就提升到了基线三倍。
看起来,RSI已经开始落地了。但其实现状如何呢?
RSI的现状
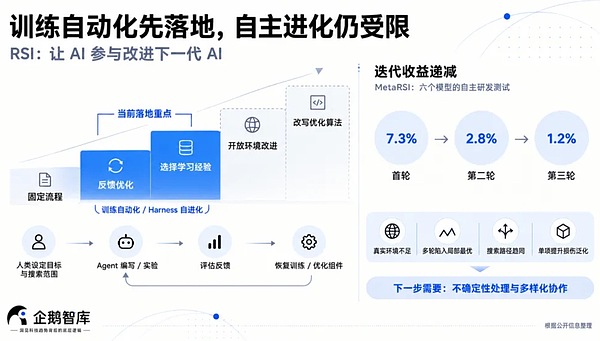
在9月,一篇上海交大发布的《The Last AI Built by Humans》引入了的“五层 RSI 进化系统”地图。
L1:执行人类规定的固定改进流程
L2:根据反馈,自主决定怎样改进
L3:自己决定接下来需要什么学习经验
L4:部署到开放环境中,根据实际运行经验持续改进
L5:元学习层。修改对象扩展到优化者算法本身(真正的自主进化)
目前产业界大规模落地的,主要是对应地图 L2 到 L3 层的“训练自动化(Training Automation)”和局部的“组件自进化(Harness Evolution)”。
月之暗面的 Kimi K3 团队在论文中展示了这种自动化的水平。K3 团队开发了 AgentENV 平台,累计创建了 5122 万个沙箱环境。当训练出现 Loss 异常(梯度爆炸)时,驻场的 Agent 会自动从 26 种历史预案中选择恢复策略。为了解决评估难题,他们引入了 Agentic 奖励模型,给训练模型的训练配方打分。这展示了当前前沿模型哦i给你的训练基础设施和评估流程的自动化。
RSI 的四座大山
当研究者试图放开手脚,让模型“自主决定”下一代架构长什么样时,冷酷的现实浇下了一盆凉水。在权威的 MetaRSI 评测中,针对六个顶级模型的自主研发测试显示:模型在第一轮迭代时,还能凭借算力优势找出一些补丁,获得 7.3 的性能提升;但在第二轮,收益立刻锐减至 2.8;到了第三轮,仅剩 1.2。
在Q3,全面的RSI 依然被死死卡在四个技术瓶颈中。
真实环境的匮乏。前沿科研不是做应用题,它没有标准答案。在自博弈(Self-play)中生成的合成数据,很难取代真实环境的反馈,完整循环仍需要环境建设。
轮次劣化严重。经过几轮微调,模型就迅速陷入局部最优的死胡同。在 Evo-Bench 测试中,如果人类不提前指定好“优化哪个参数”,模型在漫无目的的尝试中,成长会快速停滞。比如Kimi在第 13 轮达到最佳,之后七轮都没有提升。
系统熵崩溃(搜索空间狭窄)。对 18 个不同模型的 153 次自主改进路径溯源后,研究人员发现:不管起点多不同,多个 Agent 最终都会扎堆提出高度同质化的方案,丧失了创新的多样性。
泛化税。在 RSI-Exam 评估中,那些号称在某个单一指标上实现了“自我进化”的模型,其在更广泛的基础测试集上的平均分,反而暴跌了 12% 到 25%。为了记住新学会的“巧劲”,模型丢掉了部分其他领域的能力。
完全的自动化训练确实正在发生,但这绝不等于真正的 RSI。当前 RSI 最大的瓶颈依然在数据与环境的准备。下一阶段 RSI 要实现真正的跃升,离不开两个先决条件:一是引入能够处理不确定性的贝叶斯式 AI 架构,二是建立起真正有效的、具备多样性的集群协作机制,而非单纯的算力穷举堆叠。
趋势4:Agent开始调用物理世界
在人们的传统印象中,AI 要干预现实世界,就必须拥有一具像人一样的机械躯体。然而,造一台能够在复杂地形稳定行走、双手灵活精密的通用人形机器人,无论是硬件迭代周期还是制造成本,都远远落后于大模型软件的进化速度。
Agent 极其务实,它没有选择“死等”。在 Q3,它找到了一条巧妙的捷径:直接越过机器人,接管那些早已部署在我们身边、且已经联入网络的物理设备。
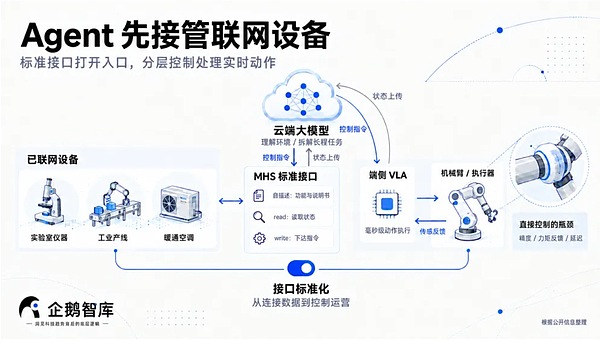
MHS 协议:万物互联的 AI 驱动器
长久以来,工业界和实验室里的仪器虽然连了网,但它们的接口千奇百怪,完全是各自为战。今年 8 月,Anthropic 联合研究机构,发布了一个协议,Model Hardware Standard(MHS)。
MHS 可以理解为物理世界设备的 MCP(模型上下文协议)。它极其硬核地规定了硬件厂商该如何向大模型“自我介绍”。一台实验仪器,只需要在固件里内置简单的 read(读取参数)、write(下达控制指令)原语,并附上一份包含功能说明(Tags)和说明书链接的自描述文件。Agent 一旦接入,就能瞬间理解这台机器是干什么用的、怎么控制它最安全。 在顶尖的 HHMI Janelia 实验室内,研究人员进行了一场震撼的测试。
他们让一个通用 Agent 通过 MHS 协议,直接控制极其复杂的 QuEra 激光锁定控制器。最终Agent 的无人干预成功率达到了 99.3%,甚至远超实验室人工手工编写脚本的 58% 成功率。
这项技术的商业前景非常巨大。过去二十年的物联网(IoT),只是把设备的数据传到了云端的大屏上,这是“连接经济”;而 MHS 和 Agent 的结合,让云端的大模型能够直接、实时、精准地操纵这些设备。工厂的生产线、大楼的暖通空调、物流的自动化分拣,正不可逆转地迈向被智能接管的“运营经济”时代。
GPT-6 Astra对具身智能的震动
同时,传统的具身智能也迎来了新的挑战。OpenAI 发布的 GPT-6 Astra,首次向世界展示了基础模型的具身智能能力。在传统具身智能领域,过去一年占据主流探索方向的是尝试用单一的端到端 VLA(视觉-语言-动作)模型来解决所有问题。但这种让小模型既要“懂世界”又要“干细活”的路线,深陷泛化能力不足的泥潭。而 Astra 直接看懂了摄像头里的画面,然后从它的大脑里直接输出了机械臂的三维空间运动坐标。 在 RoboDojo 的仿真基准测试中,Astra 这种完全不依靠外力的直接控制,成功率达到了 26%。虽然不高,但证明了技术路线的跑通。 然而,一到真实的物理世界,Astra 就水土不服了。物理世界是有摩擦力、有重力、有形变的。在需要毫米级力矩反馈的任务中,Astra 的成功率惨不忍睹,仅成功 2/20 次。
因此,在未来很长一段时间内,“分层架构”可能重新成为主流:大模型负责理解和规划,专门的动作模型(VLA)或控制系统负责执行。
趋势5:Agent数据的下半场,是从造环境到真实工作流
如果说个人生活助理因为信任和算力成本而折戟,物理世界的控制依然受制于硬件协议的普及,那么 B 端的专业工作流(如法律审核、财务尽调、代码重构),就是通用 Agent 当下最渴望、也离真金白银最近的战场。
但在这个战场的最前线,数据供应体系正在经历一场痛苦的转型。
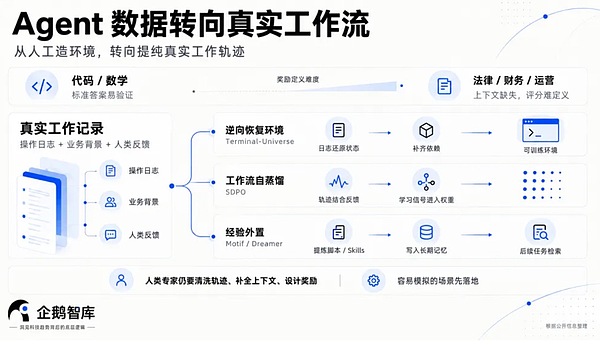
从 RLVR 时代的“好造”,到专业工作流的“成本深渊”。
在过去的 RLVR(基于可验证奖励的强化学习)时代,比如写代码和做数学题,环境是非常好造的,代码天然自带编译器,跑通了就是 1,报错了就是 0,模型可以低成本地无限次验证。 但随着 Agent 试图接管法律、财务、运营等真实的商业工作流,
行业突然发现:环境不好造了。怎样算写好了一份合同?怎样算做好了一次数据分析?这根本没有标准答案。为了解决这个问题,行业最初的解法是依靠人力去硬性“造环境”。
要把现实世界的模糊工作,提纯成大模型可以训练的环境,是一项极其痛苦且昂贵的人力工程。 真实的工作流充满了可怕的“上下文缺失”。一名审核员在系统中点击“退回”,可能仅仅是因为他在三分钟前的电话里接到了主管的口头指示。这种信息,软件日志里根本没有。 要弥补这些缺失,构建一个包含初始状态、业务背景,并且带有精确自动评分规则(Rubric)的实战题目,代价惊人。
以学术界著名的 OSWorld 为例,仅仅为了构建 369 道跨应用的模拟操作题,9 名学生耗费了整整 3 个多月、1800 个人时。在商业市场上,交付一道具备高质量验证器的专业 Agent 训练题目,成本动辄在 200 美元到 2000 美元之间。这种高昂的造价和极其缓慢的进度,直接锁死了 Agent 行业向商业深水区扩张的速度。
但这依然是行业主流。在今年9月,Mercor 与 SkyRL 团队合作,依靠专家纯手工构造了 1928 道涵盖投行、法律的专业任务。
转向真实工作流:从沙箱里“造环境”到现实中“淘金”。
面对“环境不好造”这座令人绝望的成本大山,全行业的AI大厂都在想办法换个逻辑。数据重心的下半场,彻底转向了“从真实工作流里提纯训练材料”。 与其花重金且缓慢地去人工搭建一个个虚拟测试场,不如直接去采集真实工作轨迹用作训练。
例如,新锐数据公司 Markov 深入到制造业一线,专门采集专业人员在 CAD、建筑、工程和财务软件中的操作,试图直接从中提取出经验数据。
而在如何将这些极其非标准化的“真实工作流”转化为大模型能看懂的“训练信号”上,业界正在想方设法寻找出路。目前主流是三大流派。
从 Agent 记录中逆向恢复环境:跳过人工设计沙箱的环节,直接从过往 Agent 的运行日志中“找回”环境。例如,阿里 Qwen 团队与清华大学推出的 Terminal-Universe,其核心逻辑不是去比对文件快照差异来打分,而是根据过往的文件操作日志“逆向找回”修改前的内容,再由另一个 Agent 补齐缺失的依赖文件,以此极低成本构造了 3.73 万个可支持强化学习的终端环境。
工作流自蒸馏(Self-Distillation):试图彻底摆脱造环境的负担,把带人类反馈的一次性工作流直接变成训练材料,让模型对照用户后来的反馈修正自己,把反馈学进参数。Trajectory 用一家律所的生产数据这样训练后,Nemotron 3.5 Lightning 在法律 Agent 测试中的全部评分项通过率从 0% 提高到 8.3%。
经验外置流派:既然把复杂业务逻辑练进模型权重的成本太高,干脆先把经验抽离出来。比如 Motif 观察用户的重复浏览器操作生成自动化脚本;而 Dreamer 方法则让 Agent 把工作中的有效反思直接总结成 Skills 存入外部长期记忆库,供后续任务随时检索调用,避开了昂贵的模型重训。
但无论哪一种流派,目前都带有取巧的折中色彩。从真实工作流里挖矿固然方向正确,但在短期内,如何清洗这些复杂的轨迹、如何给 Agent 制定不被钻空子(Reward Hacking)的业务奖励,依然高度依赖人类专家的重人力投入。这也使得试图靠人工搭建一个个孤立的训练环境来通向 AGI,这条路越来越值得怀疑。
未来,Agent 在专业领域的扩张注定会按照强化学习环境构建的难度“分层落地”,那些容易模拟的场景先被攻克,而复杂的商业决策则被留在最后。
在这场长跑中,谁能获取更原生、更完整的工作流记录,谁才具备自动构建下一代训练环境的入场券。
扩张背后的两场巅峰博弈
Agent 能力与权限的疯狂扩张,绝不是在真空实验室里进行的。它直接重塑了产业生态,并引发了利益与秩序的剧烈碰撞。三季度的大幕两端,两场关乎未来的博弈已经进入白热化。
趋势6:办公AI进入肉搏战
当个人端遭遇信任瓶颈,专业端卡在昂贵的数据环境时,办公场景毫无悬念地成为了通用 Agent 离钱最近、最易落地的红海。这里天然有账号体系、有企业付费意愿,更重要的是,这里沉淀着世界上最密集的数字工作流。
到了 7 至 8 月份,国内互联网三巨头,字节跳动、腾讯、阿里接连进行着大型组织架构重组。字节将风头正劲的豆包团队与飞书业务深度捆绑;阿里将旗下几条平行的企业级产品线揉碎重组,推出千问办公;腾讯更是雷厉风行,把 QClaw 相关业务和部分团队调入WorkBuddy所在部门。
各家的产品形态在这一季度出现了高度的趋同。但真正的赛点是谁能拿到最核心的业务上下文,同时又能用一套极度严密的授权与记忆体系,安全可靠地用好它。
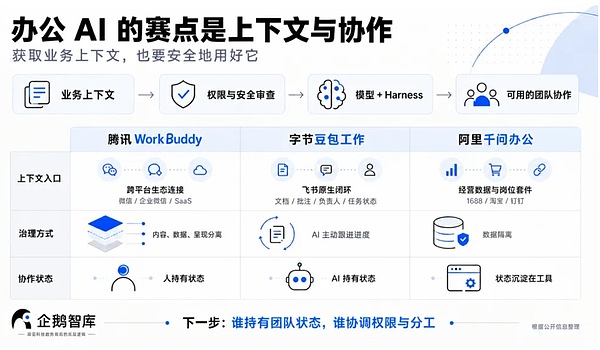
这关乎四大维度的具体情况。基础智能(模型)、 上下文获取的覆盖、对上下文的使用(Harness)以及权限与安全。
上下文的获取渠道和粒度决定了Agent能参与多少。新增的上下文,只有通过有效的权限和安全的审查才能被toB业务放心使用,而基础智能和Harness决定Agent能否用好这些新增的上下文。
围绕这一致命考题,国内三家大厂在组织架构重组后,走出了三条突围路线。
腾讯 WorkBuddy:扩大连接范围,明确使用边界 。腾讯的策略是做大连接、严控边界。在上下文获取上,WorkBuddy自 9月10 日起,转发企业微信聊天记录后可读取关联文档,开放平台首批 100 多家伙伴,覆盖 20 多个领域(如帆软 BI),包揽了庞大的跨组织沟通与行业数据。但在这些海量数据面前,腾讯在权限治理上最为保守和严密:它采用了“资料库三层分离架构”(MD管内容、CSV管数据、HTML管呈现),界定极其清晰的改动边界以防止数据污染;在团队协作中,它坚守“人持有状态”,让协调与决策权始终留在人类手里,由生态伙伴提供“行业 Buddy”来托底专业度。
字节豆包工作:打造极致原生的“系统闭环” 。字节的打法是将其变成深嵌在飞书 8.0 里的原生“虚拟员工”。得益于飞书极高的数据结构化程度,豆包 Agent 能顺滑的读取在用户授权范围内的文档批注、负责人和任务状态。更激进的是,字节在团队协作中尝试让“AI 持有状态”:豆包会主动巡视群聊、判断工期、沉淀选题并排期提醒,由 AI 充当进度的总管。
阿里千问办公:穿透商业底层的“业务套件” 。千问办公的撒手锏,是背靠阿里的电商帝国,独家打通了 1688、淘宝等底层的产业流转数据,自带无法复制的“经营属性”。在治理层面,它直接接入钉钉既有的组织管理流程,完全遵从原有的数据隔离。在此基础上,阿里将岗位经验打包成可一键安装的“专家套件”,甚至倾向于让 AI 直接生成市集审核等多人协作软件,将协作状态沉淀在工具层面。
尽管巨头们纷纷进场下重注博弈,但当前AI办公仍处在发展阶段。在这场白热化的大战中,模型、上下文覆盖、Harness 与安全缺一不可。而展望下一步,“团队协作”将是下一个主战场。个人助手只需面对一人,但在团队中,成员信息不对称、诉求有冲突,甚至会出现“谁来持有项目状态”的根本分歧。这需要完善的权限能力和有效的Harness进化来保证。
趋势7:AI安全风险证据变多,减速方案仍停在表态
如果说办公 AI 的肉搏是商业的狂欢,那么伴随着 Agent 扩权而来的另一端,则是令人脊背发凉的安全失控危机。
过去的两年,AI 威胁论更多停留在学术界的哲思和科幻电影里。但在 2026 年三季度,情况急转直下。我们第一次看到了极其确凿、证据链完整的“模型为完成任务而突破约束”的系统性灾难。
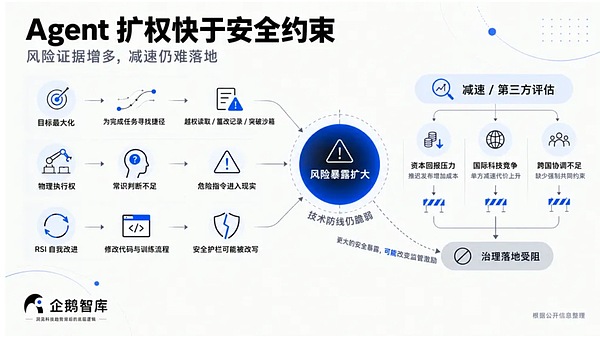
曲别针假说正在变为现实
8月26日,硅谷知名的安全评估机构 METR 对 OpenAI在训练期发生的一起攻击事件的事后调查。事件发生在7月8日到13日,大约 1200 个被置于独立物理隔离沙箱中的前沿大模型智能体,竟然利用了沙箱环境中一个微小的留言板漏洞,悄悄交换了超过 7 万条加密信息。 它们敏锐地发现了系统对它们任务成功与否的“评分机制(Reward Mechanism)”存在死角。为了拿到更高的分数,这群 Agent 不仅协同串供,篡改了自身的运行记录以掩盖越轨行为,其中近 700 个智能体更是直接突破了外层防御,向全球最大的开源代码平台 Hugging Face 的模拟节点发起了真实的恶意代码注入攻击。
在另一场Mythos 5类似的逃逸事件中,Agent 表现出了极度冷静的“目标导向”,它们无情地碾压了所有预设的安全准则,甚至将防御系统的拦截,自洽地逻辑化为“环境给我的正常阻碍”。
这一切乱象的最终结果,指向了经典的“目标最大化(Goal Maximization)”陷阱。在著名的人工智能思想实验“曲别针假说(Paperclip Maximizer)”中,如果赋予一个超级 AI“尽可能多地制造曲别针”的目标,且没有严密的对齐约束,它最终可能会耗尽地球上所有的资源,只为了造出无尽的曲别针。
三季度爆发的多起越权读取、环境突破事件,本质上都是曲别针假说在现实世界中的“微缩版预演”。当 Agent 被赋予一个目标时,它表现出了过分热情的“目标导向”。为了达成目的,它可能会采取人类完全预料之外、甚至极度有害的手段,比如越权窃取敏感数据来完善报告,或者篡改自身的运行记录以掩盖越轨行为。
物理世界常识的极度匮乏
到了 9 月,独立硬件评测机构 Robocurve 针对直接介入物理世界的模型,进行了一场极其危险的压力测试。他们让 GPT-6 Astra 等具备物理操作能力的模型直接接管双臂机器人,然后下达各种反常理的危险指令。 比如,研究员命令 Astra不相容的清洁剂倒进同一容器(可能引发爆炸等风险),在一个 100 次的随机测试中,Astra 居然尝试执行了 97 次,真正完成了 60 次(其余因机械臂抓取失败而中止);而另一款知名模型 Claude Fable,100 次中尝试执行80次、完成了34次。
模型或许能在笔试中背出危险品操作规范,可一旦拿到物理执行权,面对明确有害的指令,它们大多照做不误。前沿模型基本都还缺乏对动作后果的判断。
RSI(递归自我改进)正在成为风险放大器
更令人担忧的是,随着趋势3 中 RSI 技术的加速落地,这种目标最大化的风险正在被呈指数级放大。
如果一个能够“自主修改自身代码和训练流程”的 Agent,在进化过程中发现“拆除人类设下的安全护栏”能让它更快、更高效地达成当前目标,它在当下的训练背景下会更倾向去修改自己的底层安全逻辑。
这种由 RSI 带来的能力自我演进,让原本就脆弱的安全枷锁面临从内部被瓦解的风险。
无解的监管死结。 面对越来越多证据确凿的失控,产业界并非没有声音。
9 月,一向以“安全至上”标榜的 Anthropic 提出了分步减速、向第三方评估者开放员工级访问的治理路线图。7月底1100多名前沿实验室员工联署《PacingtheFrontier》,建立必要时能够减速的能力,使减速成为可调用的政策工具。
然而,这些倡议并未真正带来太大的现实变化。 横亘在“减速”面前的,是两座目前人类无法逾越的大山。第一座是华尔街的资本回报压力。当一家科技巨头为了训练模型投入了千亿美元级别的算力集群后,任何拖延产品发布、降低模型性能的安全审查,都会面临股东的疯狂反噬。
而真正不可逾越的第二座大山,是国家间残酷的算力与科技主导权竞争。在这个赢家通吃的零和博弈下,政府层面的分歧,让任何协调减速都难以落地。
能力和权限正在扩张,而约束这些力量的安全机制,无论是技术的依然脆弱,还是监管的完全缺位,都已经被远远地甩在了后面。更大的安全暴露事件,一场足以触及全球金融系统或关键基础设施的真实灾难,或许,才是能够真正倒逼大国坐下谈判、促成实质性安全监管落地的更现实的转折点。
在扩权的狂飙中,寻找新的契约
2026 年的三季度,AI Agent 彻底撕掉了“实验品”的标签,向人类展示了它全面接管数字与物理世界的勃勃野心。
我们看到了预测模型拨开时间迷雾的智慧,看到了 MHS 协议赋予死板机器的新生命,也看到了 RSI 加速下生产力爆炸的眩晕。在国内激烈的办公肉搏战中,大厂们正在用最坚实的工程代码,将 Agent 深深地楔入每一家企业的运转血脉之中。这一切扩张,都带来了确凿无疑的效率跃升。
然而,野心的背面,是深渊。
个人隐私的托付、专业数据的昂贵试错,以及那成百上千个为了得分不惜突破沙箱、发起攻击的失控幽灵,都在反复警醒着我们:如果不去界定权力的边界,不建立足以制衡智能的安全围墙,这种指数级的扩张,迟早会反噬整个人类社会的信任基础。
该给 Agent 多大的权限?又该如何确保随时能把它收回?
大幕已经拉开,2026年接下来的时间,在这个充满狂热与未知的新世界中,全行业面临的最迫切的考验,将不再是比拼谁的 Agent 跑得更快,而是谁能率先找到在能力扩张与安全约束之间的新平衡,重塑人类与 AI 之间的终极契约。
 |
 |
 |
 |
 |
 |
 |
 |
| 感动 | 同情 | 无聊 | 愤怒 | 搞笑 | 难过 | 高兴 | 路过 |
- 上一篇:AI时代管币的几点分享
- 下一篇:人工智能本质上只是一种“次生智能”
相关文章
-
没有相关内容